Назначение ключевого поля: база упорядоченной базы данных
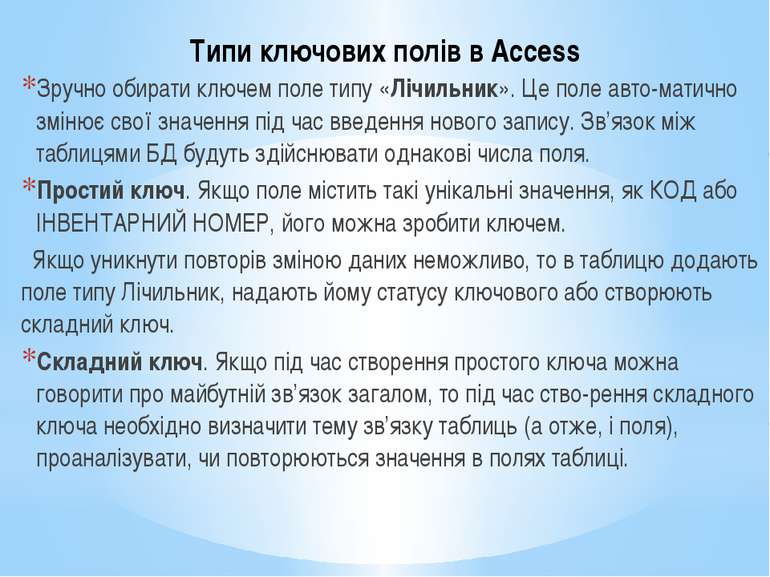
Ключевое поле стоит на страже уникальности каждой записи в таблице реляционной базы данных, как строгий охранник, не пропускающий дубликатов. Оно однозначно идентифицирует строчку, делая возможным быстрый поиск и связь с другими таблицами. Без него база превратилась бы в хаос повторов и ошибок, где один клиент мог бы иметь тысячи "портретов".
Представьте огромный склад товаров: у каждой коробки есть свой номер, и именно за ним вы знаете, где искать. Также ключевое поле служит основой для индексации, ускоряя запросы в разы, и обеспечивает референционную целостность – никто не сможет удалить клиента, если у него еще есть заказ. Это не просто технический пустяк, а фундамент стабильности всей системы.
Реляционные базы, от классического Access до мощных MySQL или PostgreSQL, полагаются на ключевые поля для нормализации данных, избегания избыточности и эффективных джойнов. Теперь разберемся, как это работает на практике, с примерами и нюансами, делающими вашу базу по-настоящему живой.
Что скрывается за понятием ключевого поля
Ключевое поле, или первичный ключ (primary key) – это колонка или набор колонок, значения которых уникальны для каждой строки таблицы. Оно не терпит повторов и пустых значений (NULL), потому что именно от этого зависит идентичность данных. В реляционной модели, предложенной Эдгаром Коддом еще в 1970-х, ключи стали основой во избежание аномалий при вставке, обновлении или удалении.
Представьте таблицу "Клиенты": без ключа вы не отличите Ивана Петренко от другого с таким же ФИО. Добавляем поле ID – и вуаля, у каждого есть свой номер. Это поле автоматически индексируется, превращая линейный поиск в молниеносный бинарный. По данным PostgreSQL documentation, первичные ключи увеличивают производительность запросов на 50-90% в огромных таблицах.
Но ключ не ограничивается идентификацией. Он становится мостом между таблицами: внешний ключ в одной ссылается на первичный в другой, создавая сеть связей. Без этого база – просто куча разрозненных листов.
Основные функции ключевого поля в действии
Первое и самое очевидное – уникальная идентификация. Каждая запись получает "паспорт", упрощающий обновление: UPDATE users SET email = 'new@example.com' WHERE id = 123. Без ключа пришлось бы искать по комбинации полей, рискуя задеть лишнее.
Второе – референционная целостность. СУБД блокирует нарушающие связи операции: не удалишь отдел, если в нем работники. Третье – производительность. Ключ автоматически создает кластерный индекс (в SQL Server или MySQL), где данные физически упорядочены. Запросы WHERE или JOIN летают, особенно в миллионных таблицах.
Четвертое – нормализация. Ключи помогают разбить данные на таблицы без дублирования: вместо повторяющихся адресов – отдельная таблица со ссылкой. Это экономит место и упрощает поддержку. Представьте: изменение почткода в одном месте, а не везде.
Типы ключевых полей: от простых до сложенных
Перед созданием таблицы выбирайте тип ключа в зависимости от данных. Начните с природных (natural) ключей – отражающих реальность: ISBN для книг, email для пользователей. Они интуитивны, но рискованны, если данные изменяются (человек переезжает).
Искусственные (surrogate) ключи – генерируемые системой: AUTO_INCREMENT в MySQL либо IDENTITY в SQL Server. Маленькие INT или BIGINT, стабильны, идеальны для больших баз. Вот пример для MySQL:
CREATE TABLE users ( id INT PRIMARY KEY AUTO_INCREMENT, name VARCHAR(100) NOT NULL, email VARCHAR(255) UNIQUE );
Составные (composite) ключи – комбинация нескольких полей, когда одно не хватает. Например, таблица "Заказ_Товары": (order_id, product_id). PostgreSQL поддерживает это нативно из SERIAL для surrogate.
Чтобы сравнить, вот таблица:
| Тип ключа | Преимущества | Недостатки | Пример |
|---|---|---|---|
| Природний | Понятный, без лишних полей | Может меняться, медленнее | email VARCHAR(255) PRIMARY KEY |
| Искусственный (surrogate) | Быстрый, стабильный, компактный | Нужны джойны для смысла | id BIGINT PRIMARY KEY IDENTITY |
| Составленный | Точная уникальность | Более сложные запросы | PRIMARY KEY (col1, col2) |
Источники данных: Microsoft Learn, MySQL Reference Manual. Выбор зависит от проекта: для e-commerce surrogate выигрывает по скорости, для путеводителей – natural.
Первичный ключ и внешний: как они танцуют вместе
Первичный ключ – хозяин таблицы, внешний (foreign key) – гость со ссылкой. В таблице "Заказ" поле user_id ссылается на id из "Users". SQL пример:
CREATE TABLE orders ( id INT PRIMARY KEY AUTO_INCREMENT, user_id INT, FOREIGN KEY (user_id) REFERENCES users(id) );
Это блокирует сиротские записи: не создашь заказ без пользователя. Связи бывают друг к другу (редко), один к многим (стандарт) и много к многим (через промежуточную таблицу). В Access это визуально в “Связях”, в SQL – через CONSTRAINT.
Внешние ключи – ключ к целостности, потому что без них база разваливается на несовместимые куски.
Индексация и производительность с ключевыми полями
СУБД автоматически строит уникальный индекс в primary key, превращая таблицу в упорядоченный словарь. MySQL InnoDB кластеризирует данные по ключу – чтение строки из индекса дает все сразу. Для миллионов записей это спасает секунды по запросу.
Избегайте TEXT/BLOB как ключи – медленные. Используйте BIGINT для масштабирования (до 9e18 записей). Тренд 2026: UUID v7 для распределенных систем, где автоинкремент конфликтует (например, в микросервисах Kubernetes).
Практические примеры в популярных СУБД
В PostgreSQL: SERIAL для auto-increment.
CREATE TABLE products (id SERIAL PRIMARY KEY, name TEXT NOT NULL);
SQL Server: IDENTITY.
- Создайте таблицу из IDENTITY(1,1).
- INSERT без id – система заполнит.
- Используйте SCOPE_IDENTITY() для последнего вставленного.
После вставки проверьте: SELECT * FROM table ORDER BY id. Все упорядочено, запросы скорые. Для составленных: PRIMARY KEY (year, month) в отчетах.
Типичные ошибки при работе с ключевыми полями
Первая ловушка – mutable natural keys: email как PK, а пользователь изменяет почту. Решение: surrogate+UNIQUE на email.
- Забыли PK: таблица без ключа – анархия, медленные запросы.
- Широкие сложенные ключи: (VARCHAR(255), DATE) – индекс раздувается, джойны тормозят.
- Игнор foreign keys: данные "висят в воздухе", удаление ломает все.
- Автоинкремент на 32-bit INT: переполнение после 2 млрд записей.
- Не учитывать каскад: DELETE CASCADE удаляет зависящие записи, рискуя данными.
Выходите из этого: планируйте заранее, тестируйте на погрузке. В производстве мониторе EXPLAIN ANALYZE в Postgres – увидите, где ключи спасают или теряют.
Ключевые поля в реальной жизни: кейсы из бизнеса
В онлайн-магазине: id продукта как PK, связь с корзиной через foreign key. Запрос на продажу: SELECT p.name, COUNT(o.id) FROM products p JOIN orders o ON p.id = o.product_id GROUP BY p.id. Быстро, потому что ключи индексированы.
В CRM: surrogate id для клиентов, natural (passport) как UNIQUE. Смена имени не ломает историю. В банковских системах UUID предотвращает конфликты репликации.
Совет: для стартапов – surrogate повсюду, для аналитики – natural где смысл. Тестируйте: INSERT 1M записей, меряйте время SELECT.
Будущее ключей: UUID и NoSQL влияние
В 2026 году UUID v7 (время+случайность) вытесняет INT в облачных базах: генерируются клиент-сайд, без race conditions. PostgreSQL: uuid-ossp extension, gen_random_uuid(). Преимущество – глобальная уникальность.
Даже NoSQL (MongoDB) перенимает идею из _id. Реляционные ключи эволюционируют, но основа – уникальность и связи – неизменна.
Экспериментируйте: создайте тестовую базу, поиграйте с ключами. Ощутите разницу на собственной коже – и ваши проекты улетят.